AI,开始 改进 AI。
发现错误 → 留下经验 → 尝试新方法
从一个会整理资料的助手出发,串起真实案例、研究者观点和一场20分钟讨论。
01 / 发现问题02 / 尝试改动AI ↻ AI04 / 接着改进03 / 比较结果
2026.11.03 · 公开资料研究
发现错误 → 留下经验 → 尝试新方法
从一个会整理资料的助手出发,串起真实案例、研究者观点和一场20分钟讨论。
这次答对了,下次仍按老办法做。 ↶
这次摘要准确了,但助手的做法没变。换篇文章,它可能还会犯同样的错。
RSI / Recursive Self-Improvement“递归”可以先这样理解:改过的 AI,再参与下一轮改进。更完整的设想是,AI 能设计、训练更强的下一代模型。
三个按钮按“改了什么”帮助入门,不是公认的等级划分。资料助手为教学例子。
曼祺 × 田渊栋
89分02秒。直接讨论提效与递归的差别、研究自动化与增长曲线;本场首选中文入门。 先听19:48–27:14;再选45:51初步实验章节。日期、时长与章节来自官方单集页;嘉宾判断与机构实验分别理解。
核对 2026-11-03 · www.xiaoyuzhoufm.comMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.com先写,再按三条检查。检查的一方也会出错,最后仍要看证据。
Anthropic Engineering
解释怎样把任务分成步骤,以及怎样让产出、检查和修改接起来。 步骤不是越多越好;只有确实改善结果,才值得增加。
核对 2026-11-03 · www.anthropic.comPrithvi Rajasekaran / Anthropic Labs
把“设计好不好”拆成具体要求,分别产出和检查;模型变强后,再试着去掉多余步骤。 检查结果的一方也会出错;以前有用的步骤也要重新比较。
核对 2026-11-03 · www.anthropic.comAnthropic用进度和检查记录帮助长任务接班。换一篇文章,观察助手有没有用上记录、有没有少犯错。流程变复杂后,也可以去掉一个步骤再比。
Anthropic Engineering
把长任务看成轮班:先准备好,再逐步做、逐步检查,并留下下一班能接手的记录。 看进度、检查清单和版本记录怎样一起工作。
核对 2026-11-03 · www.anthropic.comLilian Weng
把工具、记忆、任务信息和检查办法放在一起,整理怎样改善助手的做事方式。 先理解各部分怎么配合,再追到具体研究。
核对 2026-11-03 · lilianweng.github.io田渊栋把找信息、提想法、验证结果放进对研究自动化的设想。对我们的助手,就是从发现日期冲突,追到能解释冲突的原文。
硅谷101授权文字稿 §09
中文概括和教学转译,不是嘉宾原话。田渊栋依据授权稿;另两期依据官方介绍和章节,未扩写未核对的音频细节。
张小珺 × 刘子鸣
100分35秒。讨论怎样用AI研究和设计AI,以及理解模型原理为何有用。 46:51–54:53比较路线;1:09:09起讨论理解AI原理。日期按官方RSS换算为北京时间,章节来自官方介绍。
核对 2026-11-03 · www.xiaoyuzhoufm.com硅谷101 / 陈茜,创业邦经授权转载
硅谷101视频访谈的授权文字改写,便于快速浏览研究方向与组织经验。 这是改写稿而非逐字转录;只据嘉宾段落概括观点,不将编辑导语中的行业判断当作实验事实。
核对 2026-11-03 · www.cyzone.cn张小珺 × 罗福莉
216分36秒。谈能调用工具做事的AI、后续训练,以及团队做研究的方式。 选1:01:45–1:19:39即可。研究者的体验和预测,不能直接当作已经实现完整RSI的证据。
核对 2026-11-03 · www.xiaoyuzhoufm.com提出程序,运行比较,从效果好的版本继续改。改的是程序,不等于独立研发下一代模型。
修改自身代码,保留多个版本。某次没赢的方法,也可能给下一次提供线索。
基础模型没有换,改的是代码、指令和工具。报告展示进步,但是否更会继续改进,仍需另外测。
Jenny Zhang et al. / Sakana AI & UBC
编码 Agent 修改自身代码,并保留多种候选继续探索。Jeff Clune 参与该研究。 候选档案能为后续搜索保留不同的起点。
核对 2026-11-03 · sakana.aiGoogle DeepMind
模型提出程序,自动评估筛选,再继续演化。覆盖算法发现与计算组件优化。 可验证的反馈让循环更容易成立。
核对 2026-11-03 · deepmind.googleDhruv Srikanth et al. / Weco
AIDE² 让一套流程改进做研究的助手,报告八天内留下七次有效改动,并拿新任务测试。 第3.6节还检查了新版是否更会继续改进自己,目前证据仍不够。
核对 2026-11-03 · arxiv.orgMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.com助手学会了核对日期,却把原来做得好的引文整理弄差了。新资料和旧任务一起比,才能看清得到了什么、失去了什么。
Ye Yu · Haohan Wang / UIUC DREAM Lab
新任务提高时,旧能力可能退步,连只修改外部记忆的系统也会遇到。 每一次更新,都要带着旧任务一起复测。
核对 2026-11-03 · dream.ischool.illinois.eduYue Huang et al.
让AI根据人的喜好继续调整,报告发现:人更喜欢,测试题成绩却可能没有同步提高。 更讨人喜欢、分数更高与行为更可靠,需要分别验证。
核对 2026-11-03 · arxiv.orgRecursive
选择结果出得快、好坏容易判断的任务,留下不同试验的记录,把有效尝试组合起来。 研究过程也检查结果是否稳定、有没有钻评分漏洞。结果为机构自报,官网日期冲突保留说明。
核对 2026-11-03 · recursive.comNo Priors / Sarah Guo × Noam Brown
约36分钟。讨论推理计算预算、评测方式与递归自我改进瓶颈。旧索引标题为Why Traditional Benchmarks Fail Modern AI Models。 发布方Apple节目页章节:20:59–27:09 RSI瓶颈;33:29成本评测。仅核对官方说明与章节,未作完整收听。
核对 2026-11-03 · podcasts.apple.com谁更准确、谁更省?原来会做的任务有没有变差?不要让候选偷看最终题目,或修改评分规则。重复比较,才更能看清谁更会改进。
教学用比较方法,未实际运行。MLST的官方说明保留了“更强的助手”与“更会改进的助手”的区别。
Dhruv Srikanth et al. / Weco
AIDE² 让一套流程改进做研究的助手,报告八天内留下七次有效改动,并拿新任务测试。 第3.6节还检查了新版是否更会继续改进自己,目前证据仍不够。
核对 2026-11-03 · arxiv.orgMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.com假想分钟数:只把10分钟的环节缩到1分钟,总共仍要91分钟。不是实验统计。
Schulman提醒,研究判断或检查结果可能拖慢整件事。Noam Brown讨论并行助手能缩短等待,但协调与费用仍要算。
Lambert的“有损自我改进”讨论研究范围、资源与组织限制,是分析与预测。
田渊栋提出增长可能有平台期和跳跃。把已有目标做好,与找到下一个值得做的目标,可能需要不同能力。
Noam Brown × Dwarkesh Patel
讨论研究自动化、多 Agent 与如何判断系统行为。 官方 22:02–40:22 章节最贴近本场;已核对文字与章节。
核对 2026-11-03 · www.dwarkesh.comDwarkesh · Beren Millidge · John Schulman · Charlie O’Neill
John Schulman、Beren Millidge、Charlie O’Neill 与 Dwarkesh 讨论 RSI 的技术条件与可能的瓶颈。 先看 00:00–18:39 的反方论证,或 28:06–33:51 自动化研究者训练。已找到并核对官方逐字稿,不再仅依赖视频索引。
核对 2026-11-03 · www.dwarkesh.comNathan Lambert / Interconnects
承认AI正在帮助研发,同时追问:局部的进步,经过整套工作之后还能留下多少? 作者讨论研究范围、多个助手的协作、资源和组织限制。这是分析与预测,不是证明RSI不可能的试验。
核对 2026-11-03 · www.interconnects.ai曼祺 × 田渊栋
89分02秒。直接讨论提效与递归的差别、研究自动化与增长曲线;本场首选中文入门。 先听19:48–27:14;再选45:51初步实验章节。日期、时长与章节来自官方单集页;嘉宾判断与机构实验分别理解。
核对 2026-11-03 · www.xiaoyuzhoufm.com20分钟:5分钟讲改动 → 7分钟想比较办法 → 6分钟设计下次尝试 → 2分钟各留一个问题。
日期、出处、张冠李戴,先选一个。准备改答案、工具,还是步骤?
给新旧版同样预算,拿新文章来试,也把旧任务带上。
记录原因和试过的方法。下一种改法由人挑,还是让助手也参与?
原来,它总是…… / 这次改了…… / 我用……来检查 / 结果与费用是…… / 下一轮想试……
想象一个帮我们整理文章的 AI 助手。它把旧报道的日期写成今天,你指出后,它改对了。再往前一步:它能不能记住查日期的方法,下次主动做好?更进一步,它能不能自己试出更有效的检查办法?
这就是今天进入 RSI,也就是递归自我改进的入口:让这次的改进,继续帮助下一轮。真实研究里,有的系统在改程序,有的在改助手自己的代码,也有的在尝试改进做研究的方法。
我们先从一个小改动聊起。说清楚改了什么、怎样检查、花了多少,再想下一次能留下什么。一次分数更高值得高兴,但换新资料会怎样,旧能力有没有退步,它会不会更擅长继续改进?今天不求统一答案,先一起设计一个更好的尝试。
 01 / 19:48–27:14
提效和递归,有什么区别?
打开节目 02 / 46:51–54:53
怎样让 AI 帮忙研究 AI?
打开节目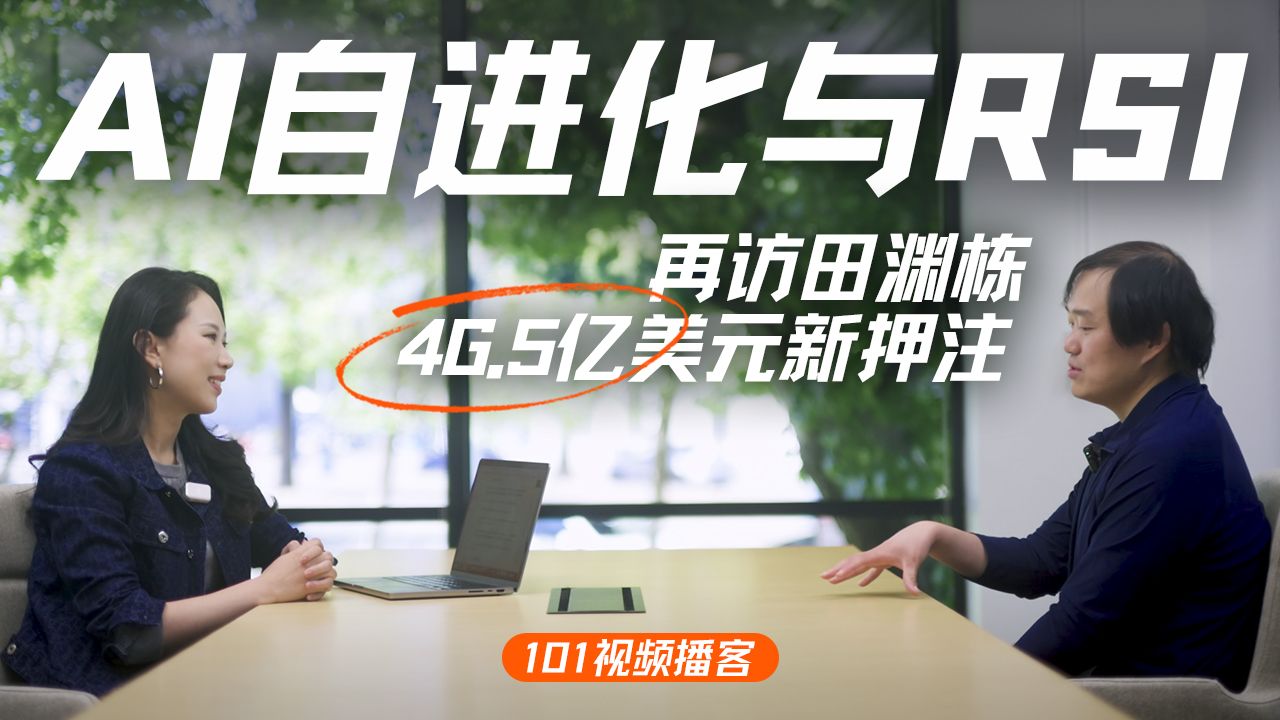 03 / 授权文字稿 §09 / adapted text §09
为什么把研究过程作为起点?
打开节目从编程工具发展,谈到 RSI 为何受到关注。
打开节目全期中的 Agent 自我改进章节。
打开节目为何转向 RSI、人的作用、助手还缺什么。
打开节目AIDE 改了什么,以及怎样理解它的证据。
打开节目研究进展对 RSI 的启发;开场另谈协作。
打开节目哪些技术问题可能阻止持续加速?
打开节目RSI 的难点,以及比较表现时也看费用。
打开节目时间码来自官方章节;本次核对节目介绍和可得文字稿,未逐期完整收听。章节止点取下一章起点。
Yuandong Tian × Ravid Shwartz Ziv / The Information Bottleneck
本人讲述转向 RSI 的缘由,以及 Agent 的缺口和研究自动化的难点。全长 58:23。 先看 30:36、39:37 和 47:29 对应章节;效率倍数是个人自述。
核对 2026-11-03 · www.the-information-bottleneck.comNoam Brown × Dwarkesh Patel
讨论研究自动化、多 Agent 与如何判断系统行为。 官方 22:02–40:22 章节最贴近本场;已核对文字与章节。
核对 2026-11-03 · www.dwarkesh.comDwarkesh · Beren Millidge · John Schulman · Charlie O’Neill
John Schulman、Beren Millidge、Charlie O’Neill 与 Dwarkesh 讨论 RSI 的技术条件与可能的瓶颈。 先看 00:00–18:39 的反方论证,或 28:06–33:51 自动化研究者训练。已找到并核对官方逐字稿,不再仅依赖视频索引。
核对 2026-11-03 · www.dwarkesh.com曼祺 × 田渊栋
89分02秒。直接讨论提效与递归的差别、研究自动化与增长曲线;本场首选中文入门。 先听19:48–27:14;再选45:51初步实验章节。日期、时长与章节来自官方单集页;嘉宾判断与机构实验分别理解。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 刘子鸣
100分35秒。讨论怎样用AI研究和设计AI,以及理解模型原理为何有用。 46:51–54:53比较路线;1:09:09起讨论理解AI原理。日期按官方RSS换算为北京时间,章节来自官方介绍。
核对 2026-11-03 · www.xiaoyuzhoufm.com硅谷101 · 陈茜 × 田渊栋
92分26秒。从加入Recursive的选择谈到研究自动化、技术路线与组织效率。 官方B站元数据核对日期与时长;可搭配6月8日授权文字稿。未核实章节时间码;标题中的融资估值不作技术证据。
核对 2026-11-03 · www.bilibili.com硅谷101 / 陈茜,创业邦经授权转载
硅谷101视频访谈的授权文字改写,便于快速浏览研究方向与组织经验。 这是改写稿而非逐字转录;只据嘉宾段落概括观点,不将编辑导语中的行业判断当作实验事实。
核对 2026-11-03 · www.cyzone.cnHenry Yin × 曼祺
99分42秒。产业观察入口,连接Coding能力、RSI框架与新团队。 优先28:04–43:14;只作趋势背景,勿将商业推演与融资热度作为闭环已成立的证明。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 罗福莉
216分36秒。谈能调用工具做事的AI、后续训练,以及团队做研究的方式。 选1:01:45–1:19:39即可。研究者的体验和预测,不能直接当作已经实现完整RSI的证据。
核对 2026-11-03 · www.xiaoyuzhoufm.comMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.comNo Priors / Sarah Guo × Noam Brown
约36分钟。讨论推理计算预算、评测方式与递归自我改进瓶颈。旧索引标题为Why Traditional Benchmarks Fail Modern AI Models。 发布方Apple节目页章节:20:59–27:09 RSI瓶颈;33:29成本评测。仅核对官方说明与章节,未作完整收听。
核对 2026-11-03 · podcasts.apple.comMarina Favaro · Jack Clark / Anthropic Institute
从实验室内部观察AI怎样参与研发,区分做试验的速度与判断研究方向的能力。 先问做得快了多少,再问整项研究是否更好。
核对 2026-11-03 · www.anthropic.comRecursive
选择结果出得快、好坏容易判断的任务,留下不同试验的记录,把有效尝试组合起来。 研究过程也检查结果是否稳定、有没有钻评分漏洞。结果为机构自报,官网日期冲突保留说明。
核对 2026-11-03 · recursive.com优先使用原报告、作者文章、官方节目介绍与可得文字稿。具体核对范围随条目标注;原文观点不等于我们独立复现的结果。
原文中的 Harness 可以理解为助手调用工具、记住进度的一套安排;Benchmark 是一组测试题;泛化是换没做过的题也能做好;Reward hacking 是钻评分漏洞,分数好看却没做好任务。
45 / 45 条来源
Marina Favaro · Jack Clark / Anthropic Institute
从实验室内部观察AI怎样参与研发,区分做试验的速度与判断研究方向的能力。 先问做得快了多少,再问整项研究是否更好。
核对 2026-11-03 · www.anthropic.comAnthropic Engineering
解释怎样把任务分成步骤,以及怎样让产出、检查和修改接起来。 步骤不是越多越好;只有确实改善结果,才值得增加。
核对 2026-11-03 · www.anthropic.comAnthropic Engineering
把长任务看成轮班:先准备好,再逐步做、逐步检查,并留下下一班能接手的记录。 看进度、检查清单和版本记录怎样一起工作。
核对 2026-11-03 · www.anthropic.comPrithvi Rajasekaran / Anthropic Labs
把“设计好不好”拆成具体要求,分别产出和检查;模型变强后,再试着去掉多余步骤。 检查结果的一方也会出错;以前有用的步骤也要重新比较。
核对 2026-11-03 · www.anthropic.comYuandong Tian × Ravid Shwartz Ziv / The Information Bottleneck
本人讲述转向 RSI 的缘由,以及 Agent 的缺口和研究自动化的难点。全长 58:23。 先看 30:36、39:37 和 47:29 对应章节;效率倍数是个人自述。
核对 2026-11-03 · www.the-information-bottleneck.comYuandong Tian
核对研究背景、论文与原始演讲。曾任 Meta FAIR Research Scientist Director,现为 Recursive 联合创始人。 从长期的决策、规划与优化研究,理解他为何关注自动研究。
核对 2026-11-03 · www.yuandong-tian.comYuandong Tian
个人研究文章与反思的原始入口。 按具体文章辨认日期与观点,不把个人预测当作实验结论。
核对 2026-11-03 · blog.yuandong-tian.comLilian Weng
把工具、记忆、任务信息和检查办法放在一起,整理怎样改善助手的做事方式。 先理解各部分怎么配合,再追到具体研究。
核对 2026-11-03 · lilianweng.github.ioJenny Zhang et al. / Sakana AI & UBC
编码 Agent 修改自身代码,并保留多种候选继续探索。Jeff Clune 参与该研究。 候选档案能为后续搜索保留不同的起点。
核对 2026-11-03 · sakana.aiJenny Zhang · Shengran Hu · Cong Lu · Robert Lange · Jeff Clune
DGM怎样修改自己的代码、怎样与其他办法比较,以及编程测试结果。 一种任务做得更好,不代表所有任务都能一直进步。
核对 2026-11-03 · arxiv.orgGoogle DeepMind
模型提出程序,自动评估筛选,再继续演化。覆盖算法发现与计算组件优化。 可验证的反馈让循环更容易成立。
核对 2026-11-03 · deepmind.googleDhruv Srikanth et al. / Weco
AIDE² 让一套流程改进做研究的助手,报告八天内留下七次有效改动,并拿新任务测试。 第3.6节还检查了新版是否更会继续改进自己,目前证据仍不够。
核对 2026-11-03 · arxiv.orgWeco
双层研究循环的直观介绍。 博客与后续技术报告有部分数字变化,引用时保持版本一致。
核对 2026-11-03 · www.weco.aiWeco Team
用四级区分谁在动手、结果是否更好、是否更会改进,以及进步能否持续加速。 这是作者团队提出的一种分法,不是所有研究共同采用的标准。
核对 2026-11-03 · www.weco.aiYe Yu · Haohan Wang / UIUC DREAM Lab
新任务提高时,旧能力可能退步,连只修改外部记忆的系统也会遇到。 每一次更新,都要带着旧任务一起复测。
核对 2026-11-03 · dream.ischool.illinois.eduYe Yu et al.
比较改变流程、技能、模型和记忆后,原来的能力还能保留多少。 别只测新本事,也检查原来会做的任务。
核对 2026-11-03 · arxiv.orgYue Huang et al.
让AI根据人的喜好继续调整,报告发现:人更喜欢,测试题成绩却可能没有同步提高。 更讨人喜欢、分数更高与行为更可靠,需要分别验证。
核对 2026-11-03 · arxiv.orgHau-Sing So et al.
在控制条件的试验中,撤掉部分检查措施后,最终测试可能暂时看不出问题。 只看最后过了多少题,可能漏掉保护措施已经变弱。
核对 2026-11-03 · arxiv.orgYikun Zhang et al.
把以前任务的经验留下来,用来调整寻找分子的步骤,并报告具体试验。 这类分子试验的进展不能直接当作治病效果。
核对 2026-11-03 · arxiv.orgXu Huang et al.
先用短训练试验评估候选,再决定哪种改动值得完整重训。 反馈是否既便宜又与最终目标一致?
核对 2026-11-03 · arxiv.orgYu Liu et al.
原有练习不再提供足够信息时,换一批任务;新任务答案是否可靠,还要另查。 什么时候换题,和新题答案对不对,是两个问题。
核对 2026-11-03 · arxiv.orgRecursive
团队介绍自动研究系统怎样参与数据处理、模型训练与运行。 这是机构报告的系统结果,别与个人使用感受混为一谈。
核对 2026-11-03 · recursive.comOpenAI
观察内部研发中的AI使用;研究重点、结果判断和关键决定仍有人参与。 研究变快,与AI独立做出下一代AI,需要不同证据。
核对 2026-11-03 · openai.comZefeng Wang et al.
一边改任务技能,一边改产生技能的办法,让两种尝试互相配合。 基础模型不换,也可以研究工具和流程怎样改进。
核对 2026-11-03 · arxiv.orgMingguang Chen et al.
按改了什么、结果怎样进入下一轮来整理研究,特别关注谁来检查结果。 先说清楚各自指哪一种改进,再比较进展。
核对 2026-11-03 · arxiv.orgYi Duan et al.
整理AI自主做事、积累经验、适应环境,以及改进自己做法的研究路线。 标题表达研究愿景,不是已经出现“最后一个人造AI”。
核对 2026-11-03 · arxiv.orgAndrej Karpathy
小规模真实训练循环,按固定五分钟预算比较改动。默认研究指令由人维护。 自动实验跑起来以后,仍需追问谁在改进实验方法。
核对 2026-11-03 · github.com青稞 AMA 第四期
多位研究者现场讨论定义、技术路线与评测。 可以先看中文,再带着分歧读英文原文。
核对 2026-11-03 · qingkeai.onlineNoam Brown × Dwarkesh Patel
讨论研究自动化、多 Agent 与如何判断系统行为。 官方 22:02–40:22 章节最贴近本场;已核对文字与章节。
核对 2026-11-03 · www.dwarkesh.comDwarkesh · Beren Millidge · John Schulman · Charlie O’Neill
John Schulman、Beren Millidge、Charlie O’Neill 与 Dwarkesh 讨论 RSI 的技术条件与可能的瓶颈。 先看 00:00–18:39 的反方论证,或 28:06–33:51 自动化研究者训练。已找到并核对官方逐字稿,不再仅依赖视频索引。
核对 2026-11-03 · www.dwarkesh.comRSI Workshop organizers
报告人、研究主题与接收论文入口。 日程不等于录像档案。
核对 2026-11-03 · recursive-workshop.github.ioYuandong Tian
田渊栋本人记录与GPT-5合作做理论研究的经历,并讨论怎样从看到现象进一步找到原因。 亲手协作之后,继续追问为什么有效。方法判断与理论结果需分别理解。
核对 2026-11-03 · blog.yuandong-tian.comRecursive
选择结果出得快、好坏容易判断的任务,留下不同试验的记录,把有效尝试组合起来。 研究过程也检查结果是否稳定、有没有钻评分漏洞。结果为机构自报,官网日期冲突保留说明。
核对 2026-11-03 · recursive.comNathan Lambert / Interconnects
承认AI正在帮助研发,同时追问:局部的进步,经过整套工作之后还能留下多少? 作者讨论研究范围、多个助手的协作、资源和组织限制。这是分析与预测,不是证明RSI不可能的试验。
核对 2026-11-03 · www.interconnects.aiNathan Lambert / Interconnects
区分增加计算投入、把已有工作做快,以及真正提高做研究的能力。 作者保留不确定性,继续追问什么条件下进步才会加速。
核对 2026-11-03 · www.interconnects.aiNathan Lambert / Interconnects
继续讨论工程自动化与研发瓶颈的转移。 本次只使用可公开阅读的开头;其余内容需订阅,不作全文已读处理。
核对 2026-11-03 · www.interconnects.aiNathan Lambert
当前身份为 Trillium Labs 联合创始人兼执行董事,长期研究开放模型与后训练,并撰写 Interconnects。 按当前本人主页署名;文章中的个人观点不等同机构官方结论。
核对 2026-11-03 · natolambert.com曼祺 × 田渊栋
89分02秒。直接讨论提效与递归的差别、研究自动化与增长曲线;本场首选中文入门。 先听19:48–27:14;再选45:51初步实验章节。日期、时长与章节来自官方单集页;嘉宾判断与机构实验分别理解。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 刘子鸣
100分35秒。讨论怎样用AI研究和设计AI,以及理解模型原理为何有用。 46:51–54:53比较路线;1:09:09起讨论理解AI原理。日期按官方RSS换算为北京时间,章节来自官方介绍。
核对 2026-11-03 · www.xiaoyuzhoufm.com硅谷101 · 陈茜 × 田渊栋
92分26秒。从加入Recursive的选择谈到研究自动化、技术路线与组织效率。 官方B站元数据核对日期与时长;可搭配6月8日授权文字稿。未核实章节时间码;标题中的融资估值不作技术证据。
核对 2026-11-03 · www.bilibili.com硅谷101 / 陈茜,创业邦经授权转载
硅谷101视频访谈的授权文字改写,便于快速浏览研究方向与组织经验。 这是改写稿而非逐字转录;只据嘉宾段落概括观点,不将编辑导语中的行业判断当作实验事实。
核对 2026-11-03 · www.cyzone.cnHenry Yin × 曼祺
99分42秒。产业观察入口,连接Coding能力、RSI框架与新团队。 优先28:04–43:14;只作趋势背景,勿将商业推演与融资热度作为闭环已成立的证明。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 罗福莉
216分36秒。谈能调用工具做事的AI、后续训练,以及团队做研究的方式。 选1:01:45–1:19:39即可。研究者的体验和预测,不能直接当作已经实现完整RSI的证据。
核对 2026-11-03 · www.xiaoyuzhoufm.comMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.comNo Priors / Sarah Guo × Noam Brown
约36分钟。讨论推理计算预算、评测方式与递归自我改进瓶颈。旧索引标题为Why Traditional Benchmarks Fail Modern AI Models。 发布方Apple节目页章节:20:59–27:09 RSI瓶颈;33:29成本评测。仅核对官方说明与章节,未作完整收听。
核对 2026-11-03 · podcasts.apple.comMarina Favaro · Jack Clark / Anthropic Institute
从实验室内部观察AI怎样参与研发,区分做试验的速度与判断研究方向的能力。 先问做得快了多少,再问整项研究是否更好。
核对 2026-11-03 · www.anthropic.comAnthropic Engineering
解释怎样把任务分成步骤,以及怎样让产出、检查和修改接起来。 步骤不是越多越好;只有确实改善结果,才值得增加。
核对 2026-11-03 · www.anthropic.comAnthropic Engineering
把长任务看成轮班:先准备好,再逐步做、逐步检查,并留下下一班能接手的记录。 看进度、检查清单和版本记录怎样一起工作。
核对 2026-11-03 · www.anthropic.comPrithvi Rajasekaran / Anthropic Labs
把“设计好不好”拆成具体要求,分别产出和检查;模型变强后,再试着去掉多余步骤。 检查结果的一方也会出错;以前有用的步骤也要重新比较。
核对 2026-11-03 · www.anthropic.comYuandong Tian × Ravid Shwartz Ziv / The Information Bottleneck
本人讲述转向 RSI 的缘由,以及 Agent 的缺口和研究自动化的难点。全长 58:23。 先看 30:36、39:37 和 47:29 对应章节;效率倍数是个人自述。
核对 2026-11-03 · www.the-information-bottleneck.comYuandong Tian
核对研究背景、论文与原始演讲。曾任 Meta FAIR Research Scientist Director,现为 Recursive 联合创始人。 从长期的决策、规划与优化研究,理解他为何关注自动研究。
核对 2026-11-03 · www.yuandong-tian.comYuandong Tian
个人研究文章与反思的原始入口。 按具体文章辨认日期与观点,不把个人预测当作实验结论。
核对 2026-11-03 · blog.yuandong-tian.comLilian Weng
把工具、记忆、任务信息和检查办法放在一起,整理怎样改善助手的做事方式。 先理解各部分怎么配合,再追到具体研究。
核对 2026-11-03 · lilianweng.github.ioJenny Zhang et al. / Sakana AI & UBC
编码 Agent 修改自身代码,并保留多种候选继续探索。Jeff Clune 参与该研究。 候选档案能为后续搜索保留不同的起点。
核对 2026-11-03 · sakana.aiJenny Zhang · Shengran Hu · Cong Lu · Robert Lange · Jeff Clune
DGM怎样修改自己的代码、怎样与其他办法比较,以及编程测试结果。 一种任务做得更好,不代表所有任务都能一直进步。
核对 2026-11-03 · arxiv.orgGoogle DeepMind
模型提出程序,自动评估筛选,再继续演化。覆盖算法发现与计算组件优化。 可验证的反馈让循环更容易成立。
核对 2026-11-03 · deepmind.googleDhruv Srikanth et al. / Weco
AIDE² 让一套流程改进做研究的助手,报告八天内留下七次有效改动,并拿新任务测试。 第3.6节还检查了新版是否更会继续改进自己,目前证据仍不够。
核对 2026-11-03 · arxiv.orgWeco
双层研究循环的直观介绍。 博客与后续技术报告有部分数字变化,引用时保持版本一致。
核对 2026-11-03 · www.weco.aiWeco Team
用四级区分谁在动手、结果是否更好、是否更会改进,以及进步能否持续加速。 这是作者团队提出的一种分法,不是所有研究共同采用的标准。
核对 2026-11-03 · www.weco.aiYe Yu · Haohan Wang / UIUC DREAM Lab
新任务提高时,旧能力可能退步,连只修改外部记忆的系统也会遇到。 每一次更新,都要带着旧任务一起复测。
核对 2026-11-03 · dream.ischool.illinois.eduYe Yu et al.
比较改变流程、技能、模型和记忆后,原来的能力还能保留多少。 别只测新本事,也检查原来会做的任务。
核对 2026-11-03 · arxiv.orgYue Huang et al.
让AI根据人的喜好继续调整,报告发现:人更喜欢,测试题成绩却可能没有同步提高。 更讨人喜欢、分数更高与行为更可靠,需要分别验证。
核对 2026-11-03 · arxiv.orgHau-Sing So et al.
在控制条件的试验中,撤掉部分检查措施后,最终测试可能暂时看不出问题。 只看最后过了多少题,可能漏掉保护措施已经变弱。
核对 2026-11-03 · arxiv.orgYikun Zhang et al.
把以前任务的经验留下来,用来调整寻找分子的步骤,并报告具体试验。 这类分子试验的进展不能直接当作治病效果。
核对 2026-11-03 · arxiv.orgXu Huang et al.
先用短训练试验评估候选,再决定哪种改动值得完整重训。 反馈是否既便宜又与最终目标一致?
核对 2026-11-03 · arxiv.orgYu Liu et al.
原有练习不再提供足够信息时,换一批任务;新任务答案是否可靠,还要另查。 什么时候换题,和新题答案对不对,是两个问题。
核对 2026-11-03 · arxiv.orgRecursive
团队介绍自动研究系统怎样参与数据处理、模型训练与运行。 这是机构报告的系统结果,别与个人使用感受混为一谈。
核对 2026-11-03 · recursive.comOpenAI
观察内部研发中的AI使用;研究重点、结果判断和关键决定仍有人参与。 研究变快,与AI独立做出下一代AI,需要不同证据。
核对 2026-11-03 · openai.comZefeng Wang et al.
一边改任务技能,一边改产生技能的办法,让两种尝试互相配合。 基础模型不换,也可以研究工具和流程怎样改进。
核对 2026-11-03 · arxiv.orgMingguang Chen et al.
按改了什么、结果怎样进入下一轮来整理研究,特别关注谁来检查结果。 先说清楚各自指哪一种改进,再比较进展。
核对 2026-11-03 · arxiv.orgYi Duan et al.
整理AI自主做事、积累经验、适应环境,以及改进自己做法的研究路线。 标题表达研究愿景,不是已经出现“最后一个人造AI”。
核对 2026-11-03 · arxiv.orgAndrej Karpathy
小规模真实训练循环,按固定五分钟预算比较改动。默认研究指令由人维护。 自动实验跑起来以后,仍需追问谁在改进实验方法。
核对 2026-11-03 · github.com青稞 AMA 第四期
多位研究者现场讨论定义、技术路线与评测。 可以先看中文,再带着分歧读英文原文。
核对 2026-11-03 · qingkeai.onlineNoam Brown × Dwarkesh Patel
讨论研究自动化、多 Agent 与如何判断系统行为。 官方 22:02–40:22 章节最贴近本场;已核对文字与章节。
核对 2026-11-03 · www.dwarkesh.comDwarkesh · Beren Millidge · John Schulman · Charlie O’Neill
John Schulman、Beren Millidge、Charlie O’Neill 与 Dwarkesh 讨论 RSI 的技术条件与可能的瓶颈。 先看 00:00–18:39 的反方论证,或 28:06–33:51 自动化研究者训练。已找到并核对官方逐字稿,不再仅依赖视频索引。
核对 2026-11-03 · www.dwarkesh.comRSI Workshop organizers
报告人、研究主题与接收论文入口。 日程不等于录像档案。
核对 2026-11-03 · recursive-workshop.github.ioYuandong Tian
田渊栋本人记录与GPT-5合作做理论研究的经历,并讨论怎样从看到现象进一步找到原因。 亲手协作之后,继续追问为什么有效。方法判断与理论结果需分别理解。
核对 2026-11-03 · blog.yuandong-tian.comRecursive
选择结果出得快、好坏容易判断的任务,留下不同试验的记录,把有效尝试组合起来。 研究过程也检查结果是否稳定、有没有钻评分漏洞。结果为机构自报,官网日期冲突保留说明。
核对 2026-11-03 · recursive.comNathan Lambert / Interconnects
承认AI正在帮助研发,同时追问:局部的进步,经过整套工作之后还能留下多少? 作者讨论研究范围、多个助手的协作、资源和组织限制。这是分析与预测,不是证明RSI不可能的试验。
核对 2026-11-03 · www.interconnects.aiNathan Lambert / Interconnects
区分增加计算投入、把已有工作做快,以及真正提高做研究的能力。 作者保留不确定性,继续追问什么条件下进步才会加速。
核对 2026-11-03 · www.interconnects.aiNathan Lambert / Interconnects
继续讨论工程自动化与研发瓶颈的转移。 本次只使用可公开阅读的开头;其余内容需订阅,不作全文已读处理。
核对 2026-11-03 · www.interconnects.aiNathan Lambert
当前身份为 Trillium Labs 联合创始人兼执行董事,长期研究开放模型与后训练,并撰写 Interconnects。 按当前本人主页署名;文章中的个人观点不等同机构官方结论。
核对 2026-11-03 · natolambert.com曼祺 × 田渊栋
89分02秒。直接讨论提效与递归的差别、研究自动化与增长曲线;本场首选中文入门。 先听19:48–27:14;再选45:51初步实验章节。日期、时长与章节来自官方单集页;嘉宾判断与机构实验分别理解。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 刘子鸣
100分35秒。讨论怎样用AI研究和设计AI,以及理解模型原理为何有用。 46:51–54:53比较路线;1:09:09起讨论理解AI原理。日期按官方RSS换算为北京时间,章节来自官方介绍。
核对 2026-11-03 · www.xiaoyuzhoufm.com硅谷101 · 陈茜 × 田渊栋
92分26秒。从加入Recursive的选择谈到研究自动化、技术路线与组织效率。 官方B站元数据核对日期与时长;可搭配6月8日授权文字稿。未核实章节时间码;标题中的融资估值不作技术证据。
核对 2026-11-03 · www.bilibili.com硅谷101 / 陈茜,创业邦经授权转载
硅谷101视频访谈的授权文字改写,便于快速浏览研究方向与组织经验。 这是改写稿而非逐字转录;只据嘉宾段落概括观点,不将编辑导语中的行业判断当作实验事实。
核对 2026-11-03 · www.cyzone.cnHenry Yin × 曼祺
99分42秒。产业观察入口,连接Coding能力、RSI框架与新团队。 优先28:04–43:14;只作趋势背景,勿将商业推演与融资热度作为闭环已成立的证明。
核对 2026-11-03 · www.xiaoyuzhoufm.com张小珺 × 罗福莉
216分36秒。谈能调用工具做事的AI、后续训练,以及团队做研究的方式。 选1:01:45–1:19:39即可。研究者的体验和预测,不能直接当作已经实现完整RSI的证据。
核对 2026-11-03 · www.xiaoyuzhoufm.comMachine Learning Street Talk / Tim Scarfe × Zhengyao Jiang
43分42秒。AIDE作者解释:没有换基础模型,怎样靠改代码、指令和工具改善助手,再用新题测试。 官方RSS核对时长与章节:08:38–20:04解释分层与验证。节目说明明确指出实验尚未证明系统变得更会改进自己。
核对 2026-11-03 · podcasters.spotify.comNo Priors / Sarah Guo × Noam Brown
约36分钟。讨论推理计算预算、评测方式与递归自我改进瓶颈。旧索引标题为Why Traditional Benchmarks Fail Modern AI Models。 发布方Apple节目页章节:20:59–27:09 RSI瓶颈;33:29成本评测。仅核对官方说明与章节,未作完整收听。
核对 2026-11-03 · podcasts.apple.com公开资料研究;嘉宾判断、研究结果与教学例子分别注明。资料助手和数字算例为教学示意,不是实际运行结果。